Expertos de la OMPI y el Ministerio de Cultura de España analizaron en Santo Domingo los desafíos que plantea el entrenamiento de sistemas de IA con contenidos protegidos por derecho de autor.
SANTO DOMINGO, República Dominicana. – La expansión de la inteligencia artificial ha abierto un nuevo frente para la protección del derecho de autor: determinar cómo pueden utilizarse obras protegidas para entrenar sistemas de IA y qué mecanismos deben garantizar una remuneración justa para sus creadores.
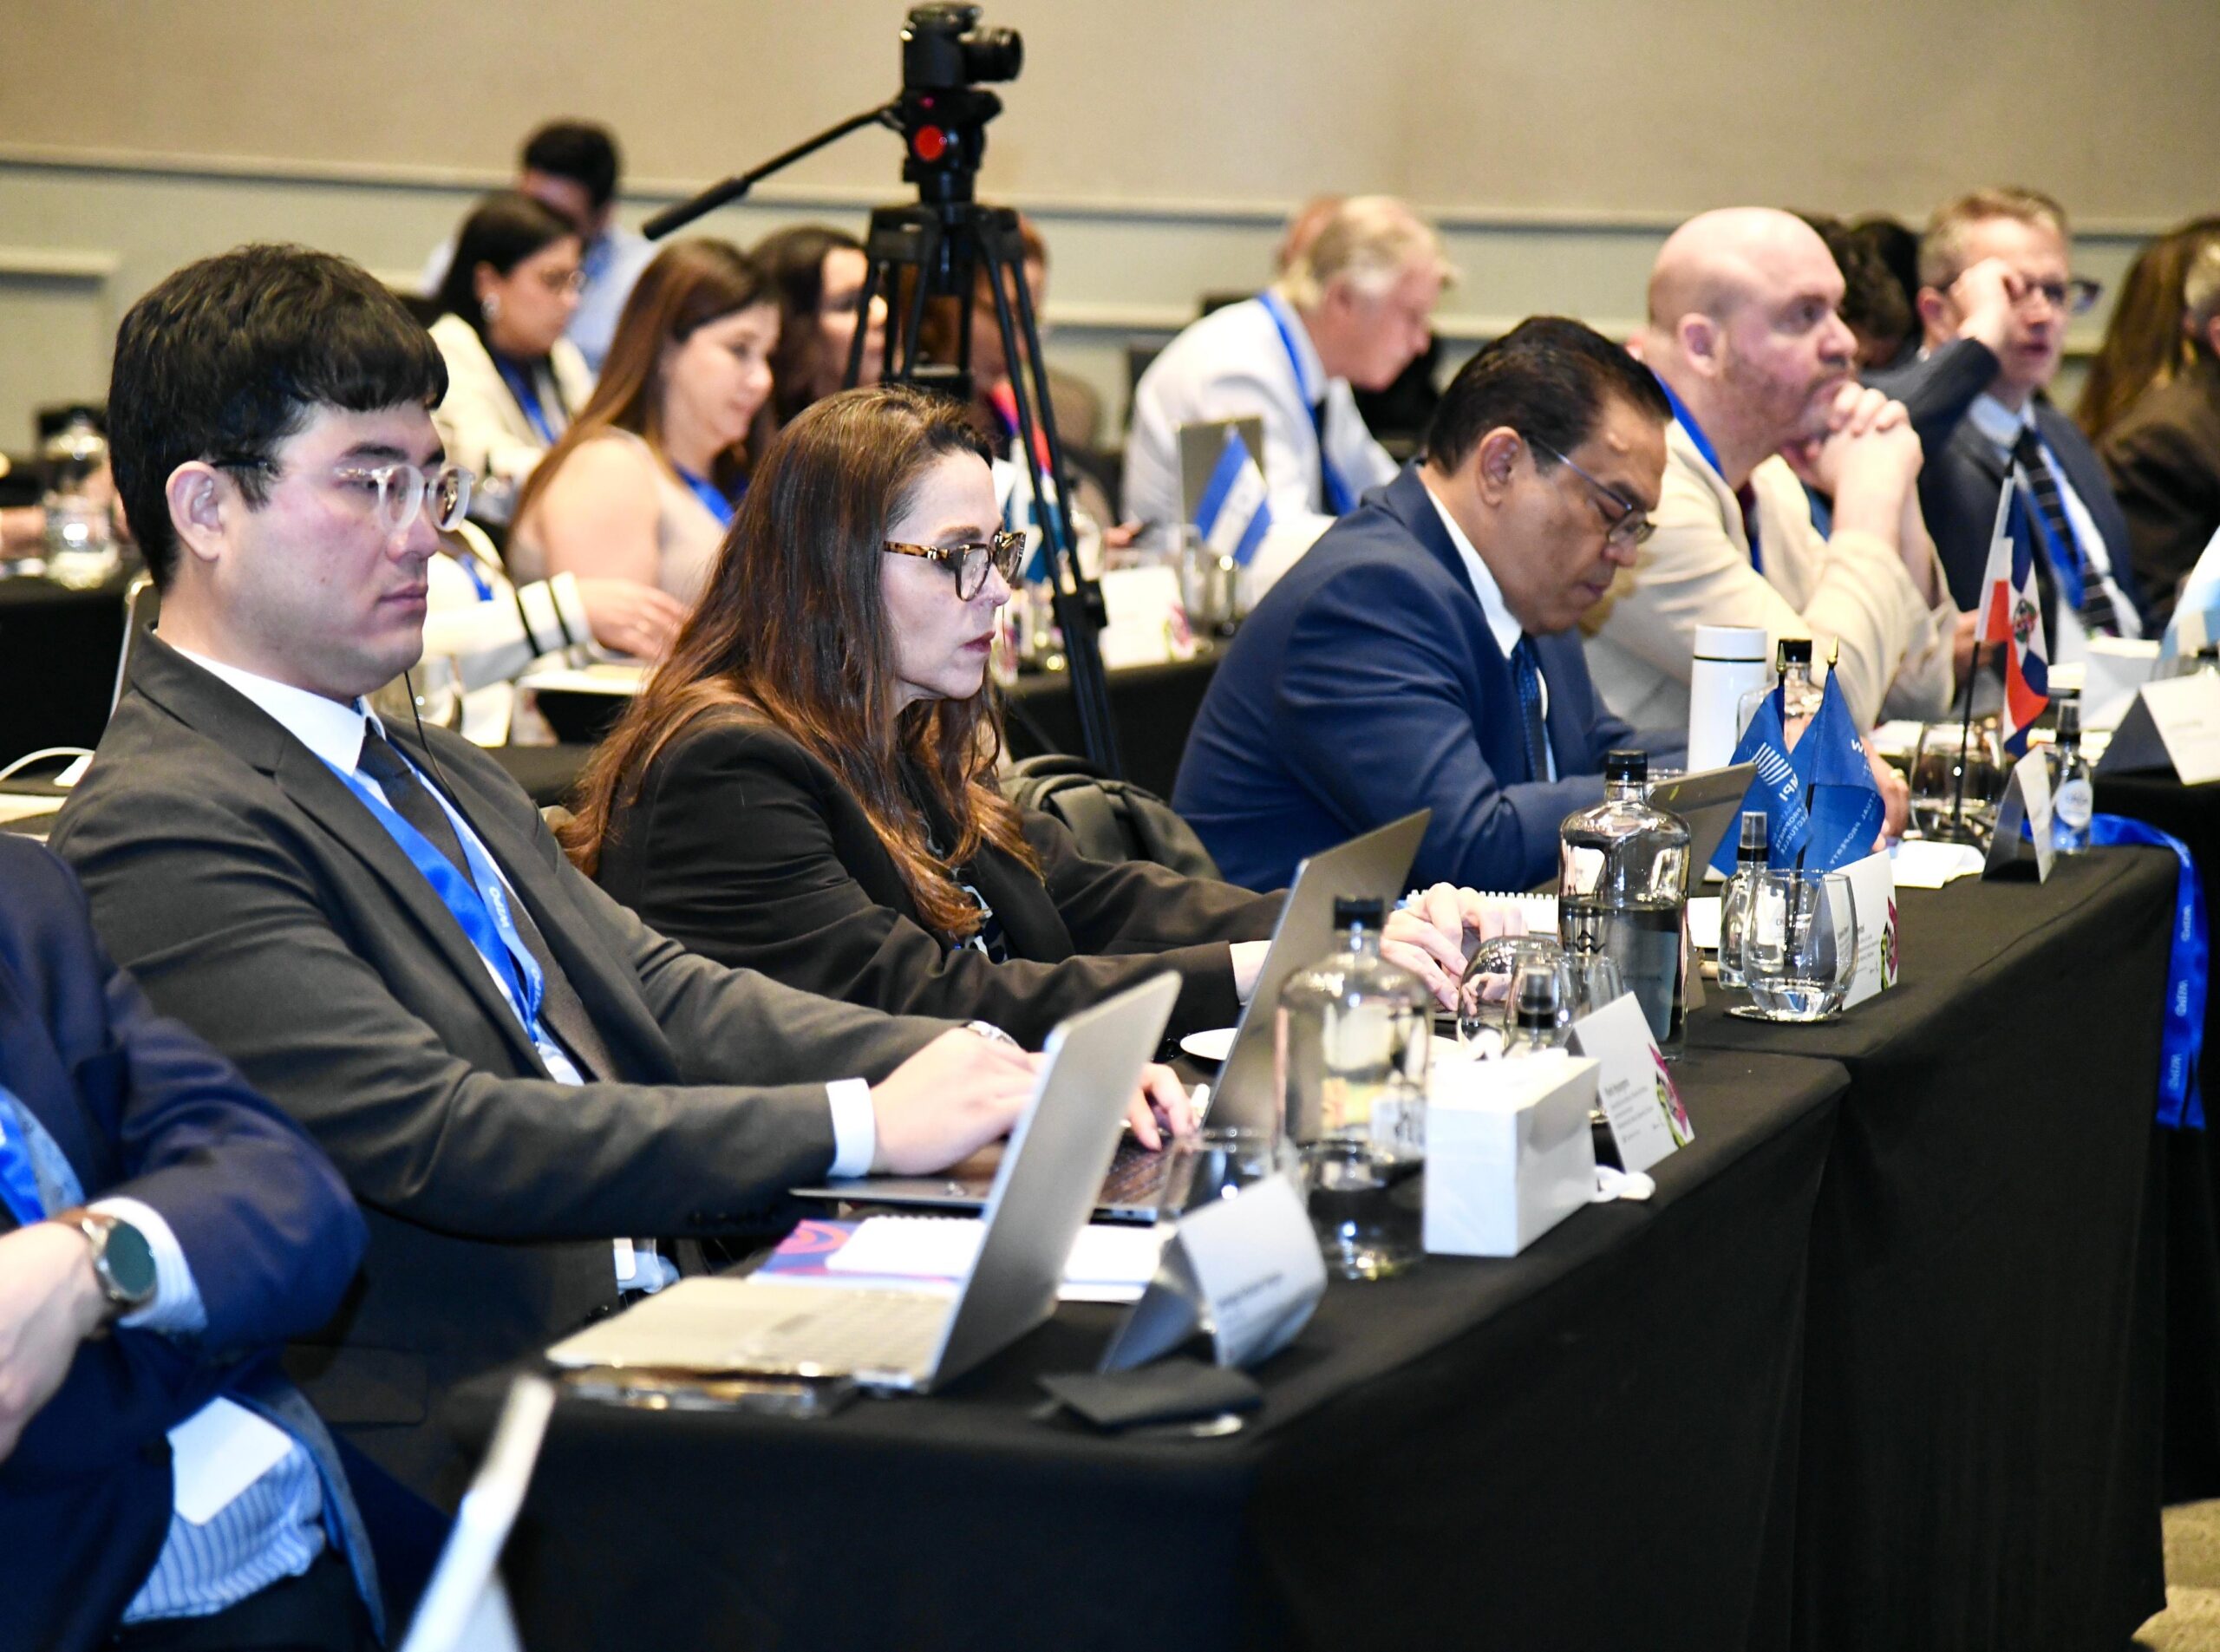
El tema fue abordado este 10 de noviembre durante el Curso avanzado sobre la gestión de la transformación del derecho de autor en América Latina, organizado por la Organización Mundial de la Propiedad Intelectual (OMPI) y la Oficina Nacional de Derecho de Autor (ONDA), con la participación de representantes de 17 países de América Latina y el Caribe.
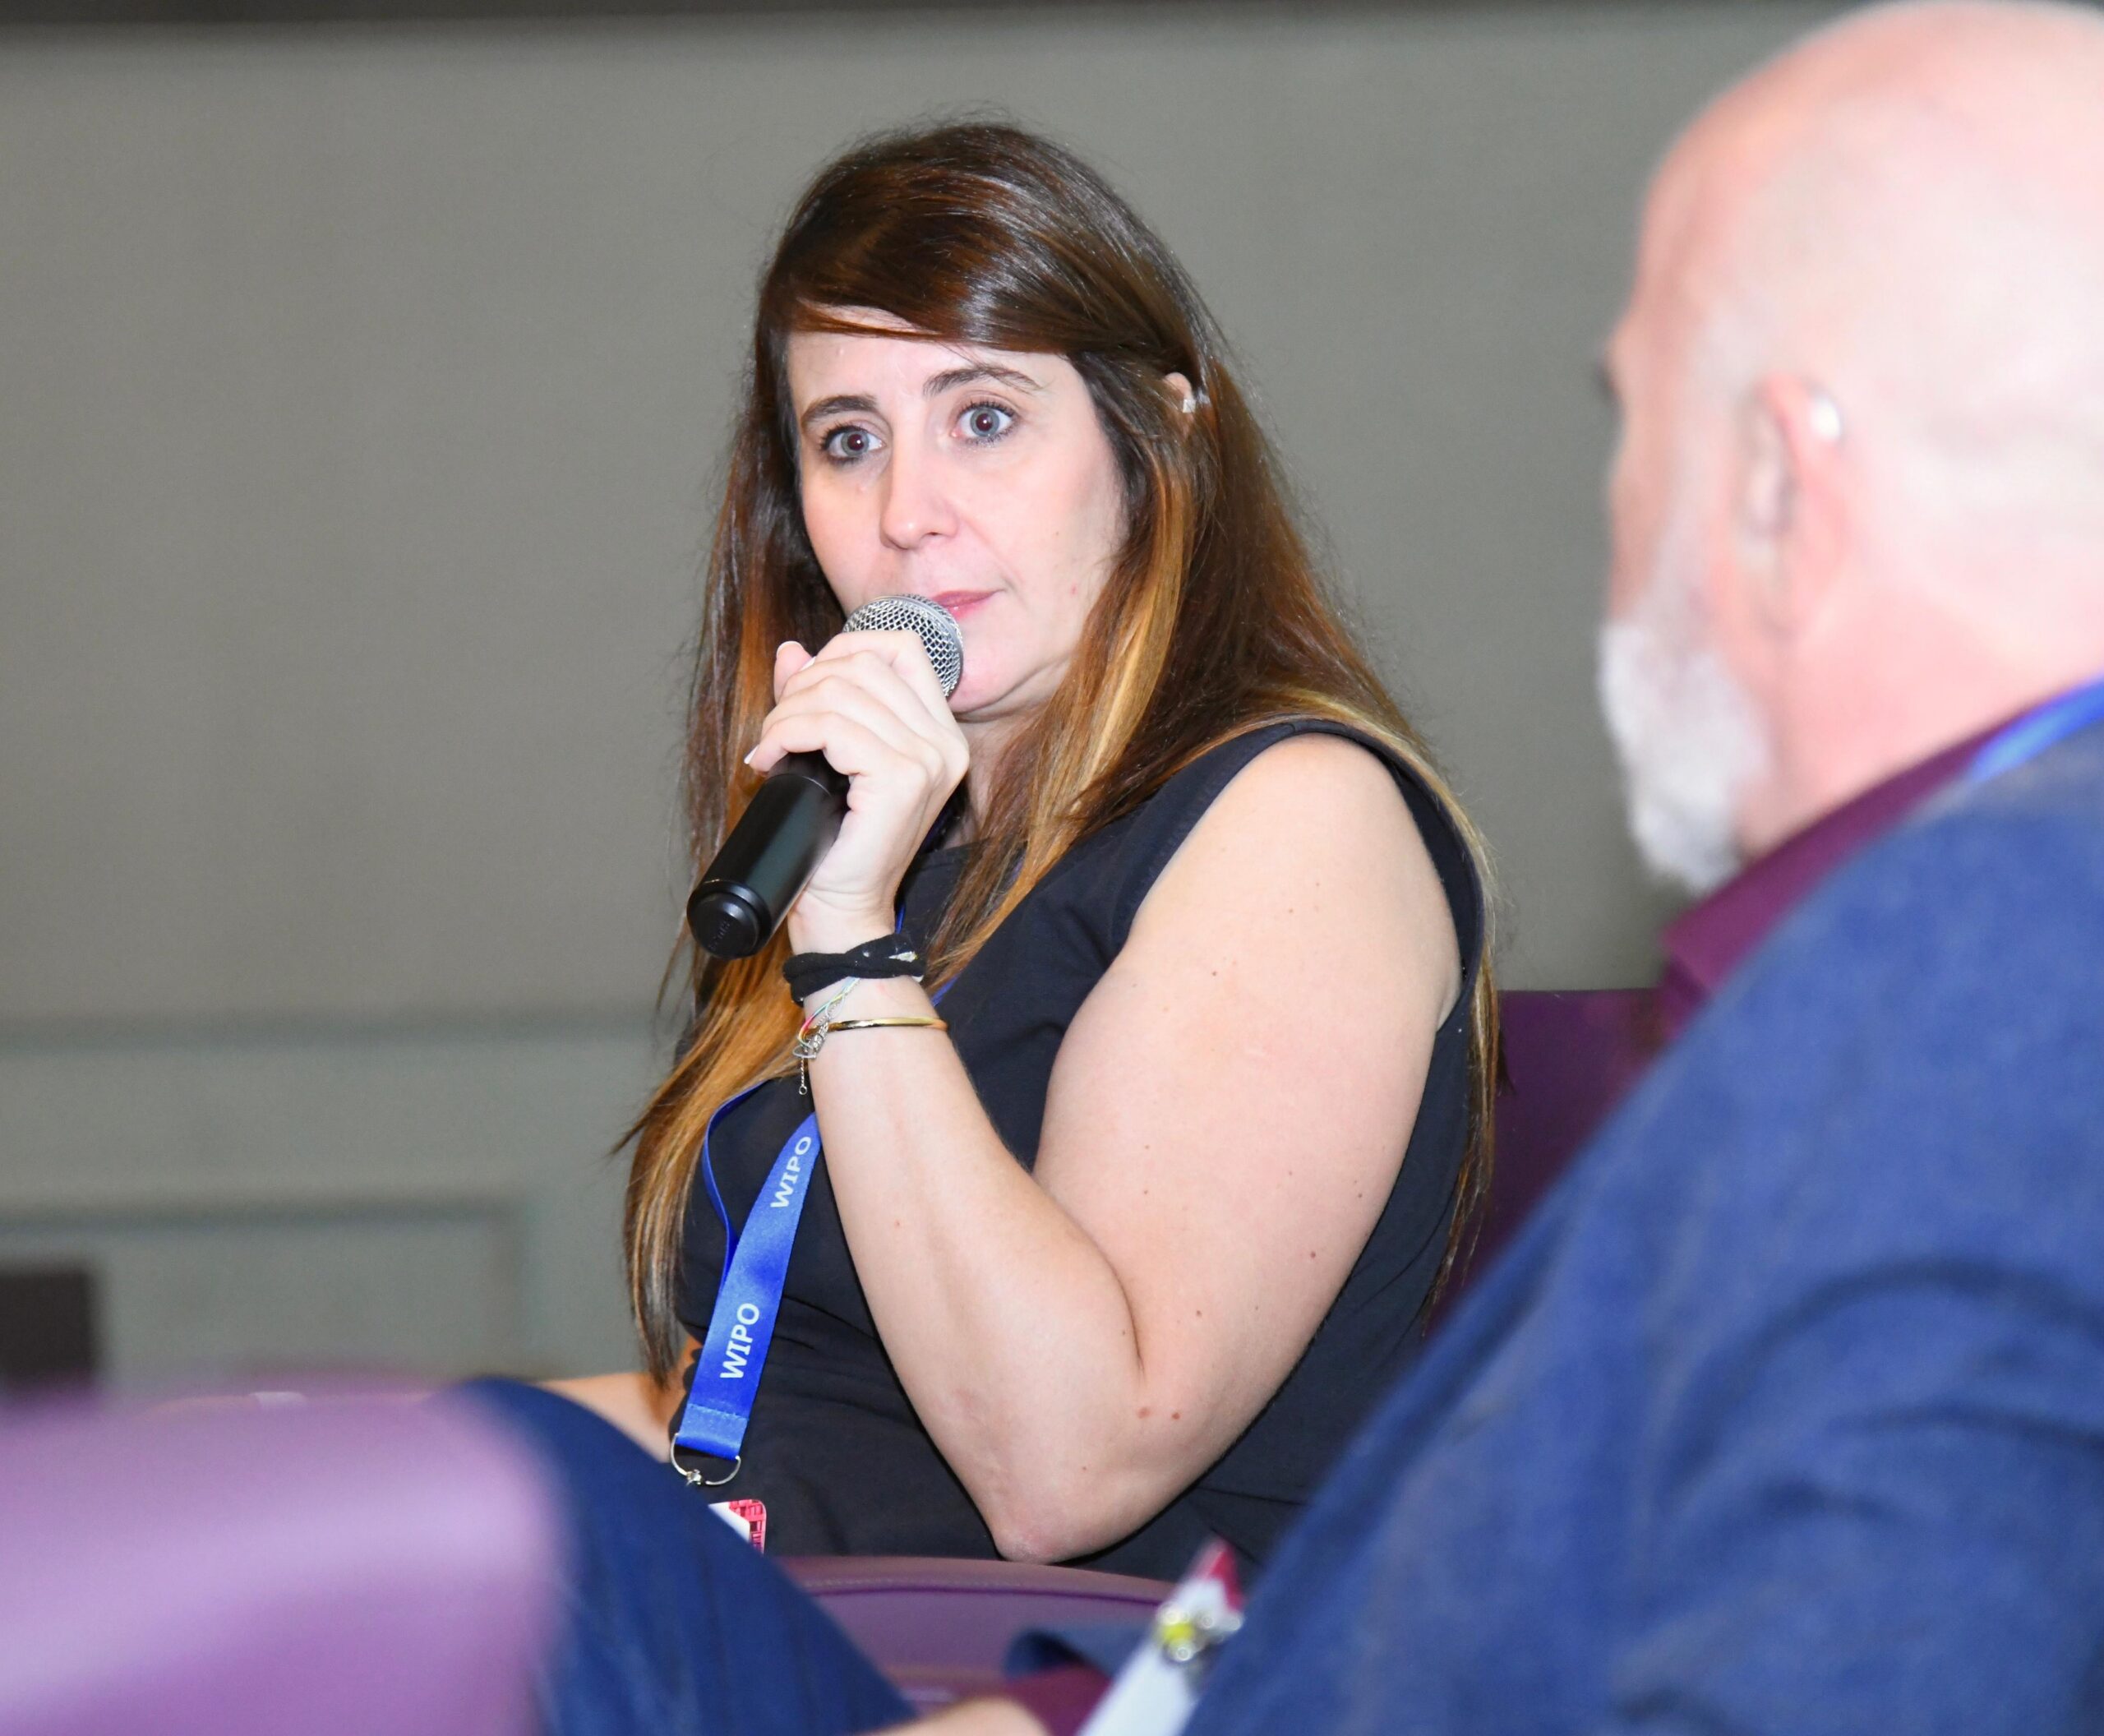
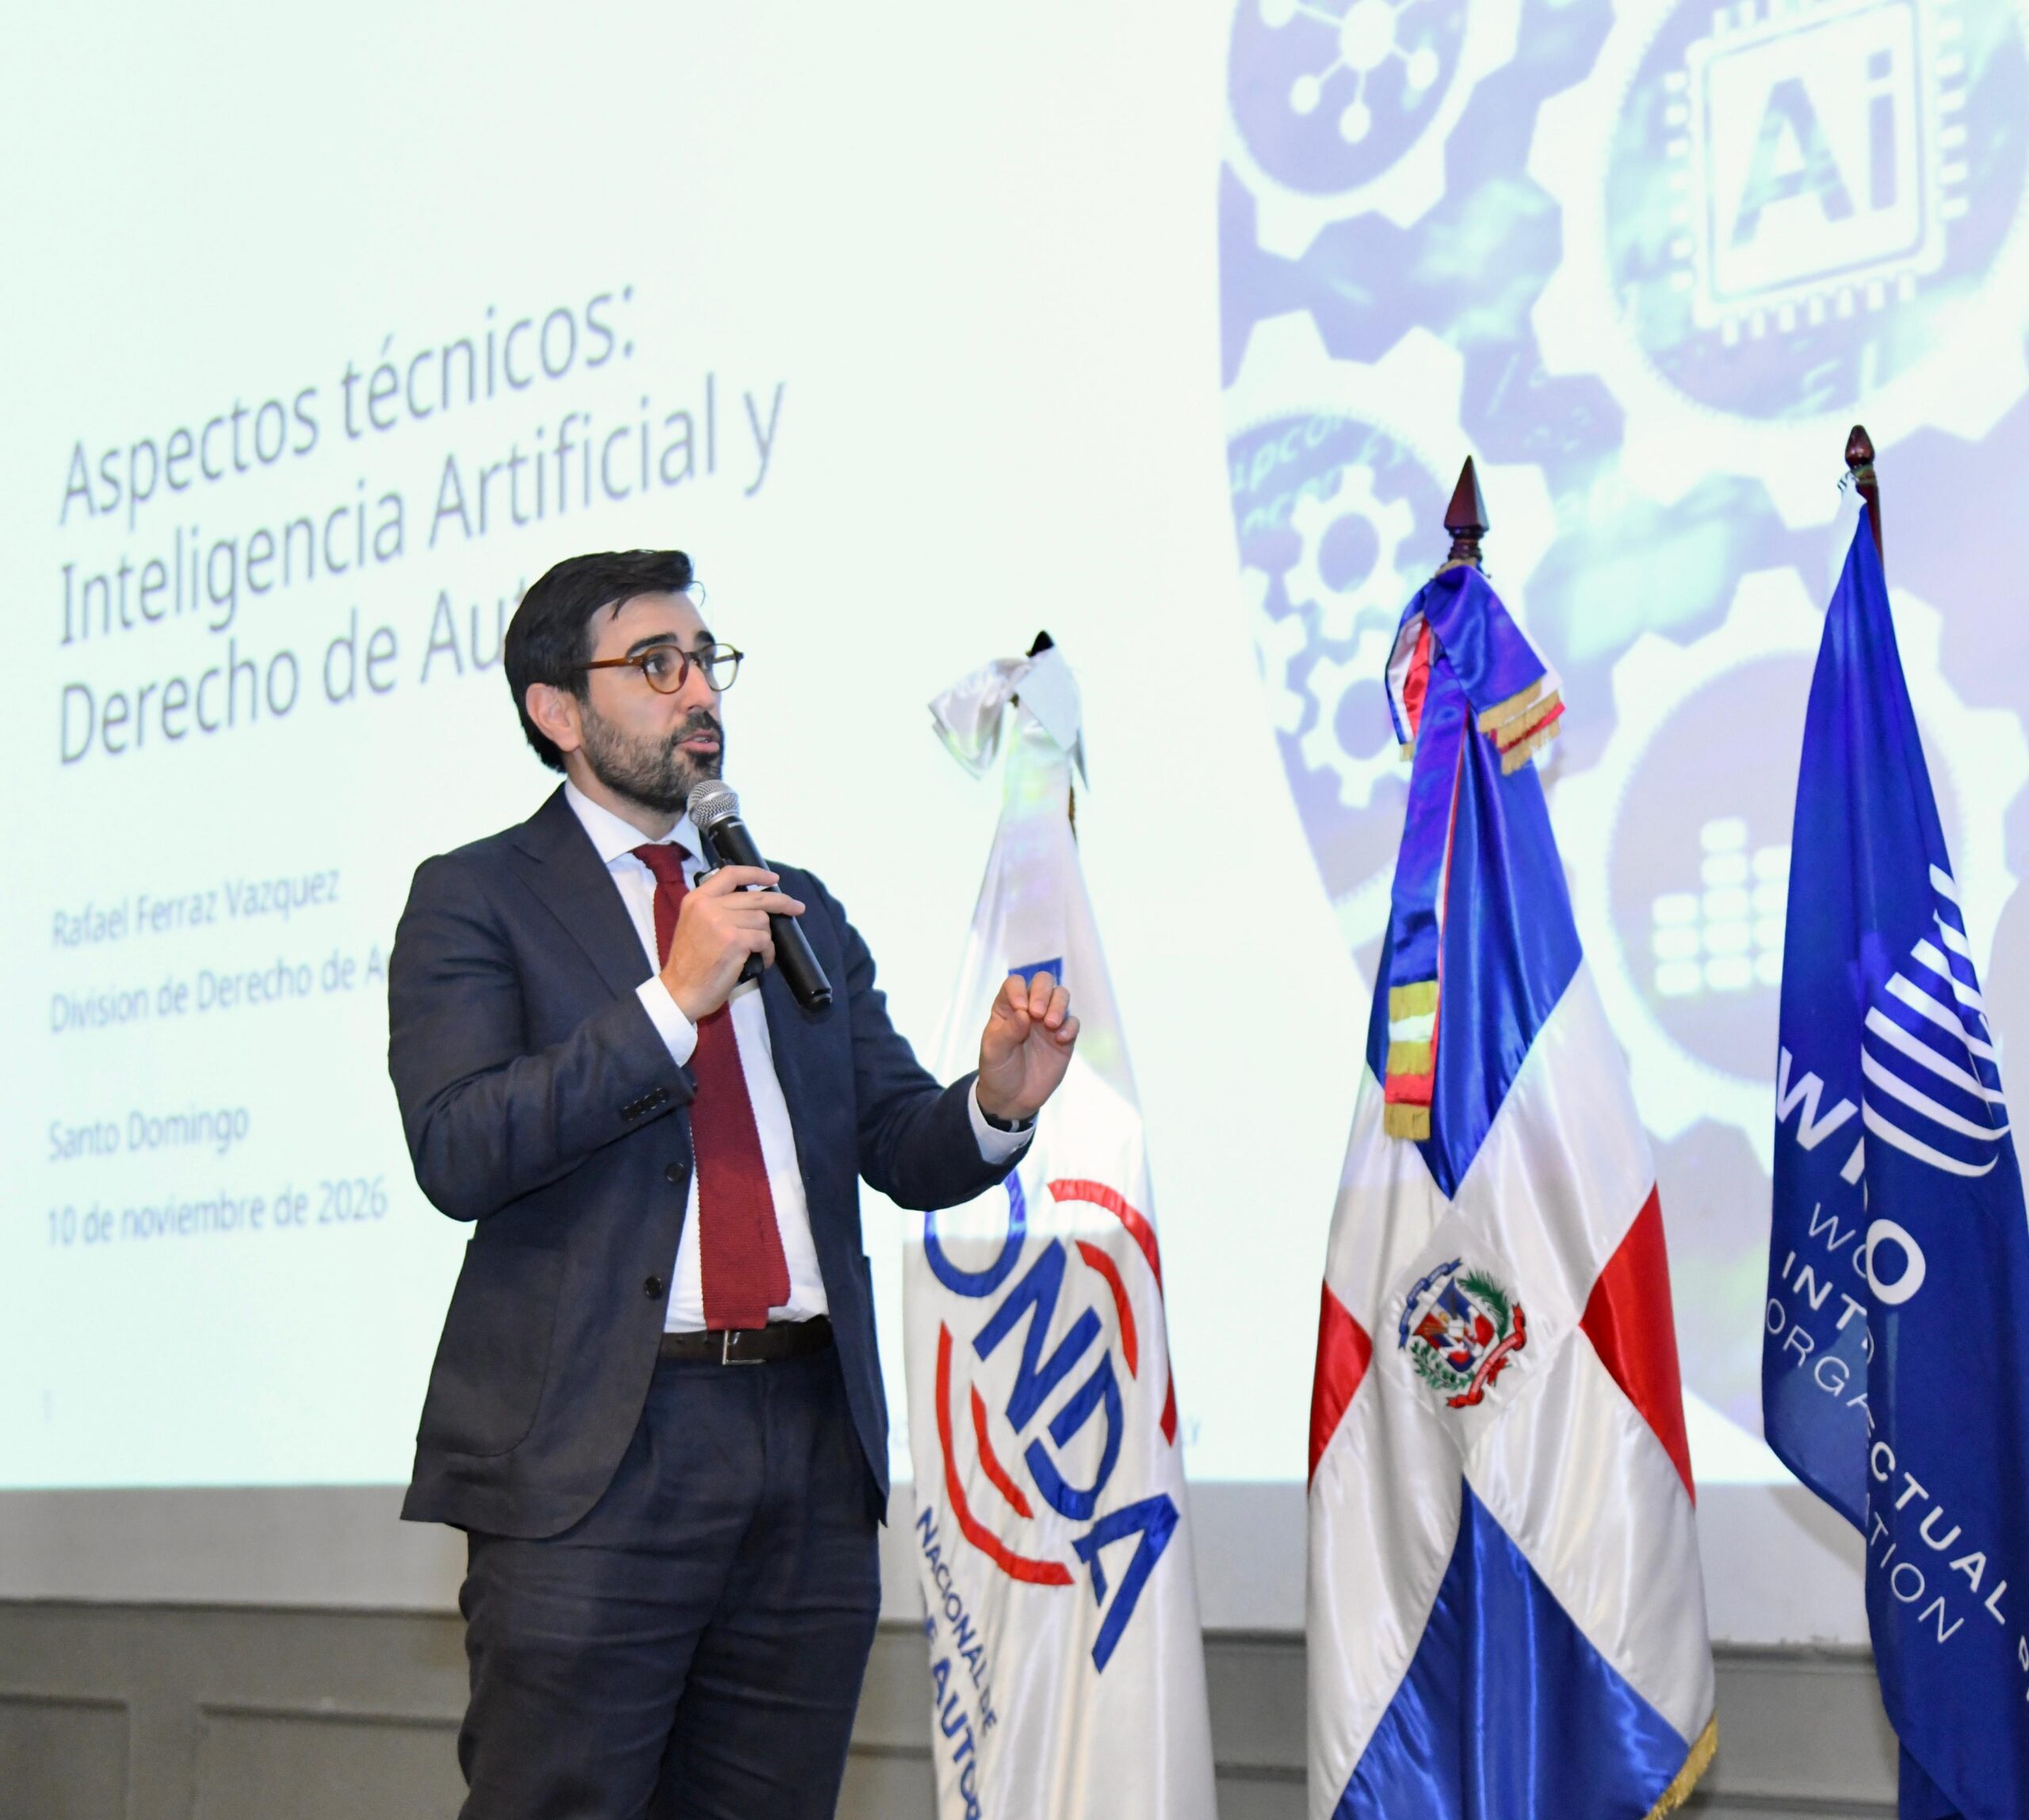
Las exposiciones de Carmen Páez Soria, subsecretaria del Ministerio de Cultura de España, y Rafael Ferraz Vázquez, especialista de la División de Derecho de Autor de la OMPI, permitieron examinar el fenómeno desde dos perspectivas: la protección de los creadores y los procesos técnicos mediante los cuales los sistemas de inteligencia artificial incorporan grandes volúmenes de contenidos.
Páez Soria destacó que la transformación tecnológica debe avanzar sin dejar de reconocer a las personas que se encuentran detrás de las obras utilizadas por las nuevas herramientas.
“Hay algo que no podemos perder de vista: detrás de cada obra, de cada canción, de cada película, de cada libro, de cada creación artística hay una persona muy talentosa”, expresó.
La especialista también resaltó la importancia de fortalecer las instituciones encargadas de proteger la creatividad y garantizar los derechos de autores, artistas y demás titulares.
Qué ocurre con las obras utilizadas para entrenar la IA
Durante su intervención, Ferraz Vázquez explicó que el desarrollo de los sistemas de inteligencia artificial generativa requiere la recopilación y procesamiento de grandes cantidades de información.
Entre las fuentes pueden encontrarse contenidos obtenidos mediante licencias directas o de gestión colectiva, materiales con licencias abiertas, información recopilada mediante rastreos automatizados de páginas web y otros contenidos cuyo uso puede generar interrogantes sobre las autorizaciones requeridas.
Uno de los puntos analizados fue el web crawling o data scraping, mediante el cual sistemas automatizados recopilan información disponible en internet. El especialista llamó la atención sobre la relación entre el volumen de contenidos que pueden ser recopilados y el tráfico que posteriormente reciben los sitios de donde estos proceden.
El desafío también alcanza a las industrias editorial y audiovisual, donde identificar a los titulares de los derechos y determinar quién está facultado para autorizar determinados usos puede dificultar los procesos de licenciamiento.
De las obras al entrenamiento de los modelos
Ferraz explicó que, una vez recopilados los contenidos, estos atraviesan diferentes procesos técnicos antes de ser utilizados para entrenar los modelos.
Entre ellos se encuentra la tokenización, que transforma textos y otros datos en unidades que pueden ser procesadas por los sistemas, así como los embeddings, representaciones matemáticas que permiten establecer relaciones entre palabras, conceptos y contextos.
En los sistemas destinados a generar imágenes, música y videos también intervienen modelos de difusión, capaces de aprender patrones a partir de procesos de incorporación y eliminación progresiva de ruido.
Estos procedimientos introducen nuevas interrogantes jurídicas, ya que el análisis no se limita a determinar si una obra terminada fue utilizada, sino también qué reproducciones y copias pueden generarse durante las distintas etapas de preparación y entrenamiento de los modelos.
Licencias, reservas de derechos y remuneración
Entre las alternativas analizadas figura el desarrollo de mecanismos de reserva de derechos (opt-out) y sistemas de licenciamiento que permitan gestionar las autorizaciones de manera más eficiente.
El debate sobre una eventual remuneración equitativa también debe considerar, según lo expuesto durante el curso, el uso de las obras durante el entrenamiento, los resultados generados por los sistemas y el impacto que estos puedan producir sobre el mercado de las creaciones humanas.
A esta discusión se suma la dimensión internacional. Un modelo puede ser entrenado en un país bajo determinadas excepciones legales y posteriormente utilizarse en territorios con normas diferentes, lo que plantea retos para la regulación y la observancia del derecho de autor.
Páez Soria también destacó la necesidad de fortalecer los sistemas de gestión colectiva y mejorar sus mecanismos de supervisión y transparencia.
“Estamos haciendo por los organismos igual que ustedes: organizar, vigilar y transparentar todo el sistema de sociedades de gestión”, afirmó al referirse al trabajo que se desarrolla en República Dominicana.
El programa del curso, que concluye este jueves, contempla además discusiones sobre música en plataformas de streaming, distribución audiovisual digital, tarifas, costos administrativos, buenas prácticas y mecanismos alternativos de solución de conflictos en materia de propiedad intelectual.
El encuentro plantea así uno de los principales desafíos para el derecho de autor en la era de la inteligencia artificial: establecer reglas que permitan el desarrollo tecnológico sin desvincularlo del reconocimiento, autorización y eventual remuneración de quienes crean las obras que alimentan estos sistemas.